洛谷 P3695 CYaRon!语
PL 系列登神长阶(1/3)
EP2:题解 P11738 未来程序·改
EP3:题解 UVA12423 Mua(III) - Full Interpreter(咕咕中)
本来是想投题解的,但是仔细阅读了一下主题库题解规范,发现这篇文章更加适合单独作为一篇 blog 阅读而非挂在题解区里污染环境,所以就这样了。
0xff 开始之前
这道题我很早以前就开始看了,那时还只有 星野梦美 大佬的一篇题解。而到现在,我终于是有了时间和能力来切掉这道题,以及写这道题的题解。
这道题实在是一道好题,既保证了作为一道大模拟的难度,同时又是一门极其简单的编程语言,和目前国内外所有的编程语言示例相比,我敢说这个语言是最简单的,连函数调用都不存在,从而使得它成为了新手入坑自制编程语言的一个绝佳途径。
然而,非常不幸的是,目前整个题解区的方法虽然都能通过本题(废话),但是可扩展性极弱,换个语言立马歇菜,比如隔壁未来程序·改,但是未来程序·改的语法与这个语言大不相同,还有函数之类的,于是模拟得全部重写(虽说我们的代码也要改,但总体逻辑不变,只有一些细节上的问题)。
总之,通过阅读这篇题解,你将可以学习到自制编程语言的有关知识(然而只能算入门中的入门),同时还能收获 A 掉一道紫题的成就感(逃)
0x00 你需要什么
或许看到“自制编程语言”,很多人会立刻联想到那本厚厚的《编译原理》,然后回想起被那一堆黑色封面的书支配的恐惧:

(《编译原理》位于左下角被挡住了)
如果我说,其实你并不需要学这些呢?
《编译原理》不教你做编译器,它教你做编译器的编译器。——我的某位群友
虽然说这个观点并不是那么的严谨,但大部分我还是支持的:实践一个最简单的编译器不需要去啃那本黑皮书,只需要那本黑皮书提供的大框架就行了。
既然你不需要(至少不很需要)编译原理,你需要什么呢?我认为以下几点是比较重要的:
- 时间。这个是最重要的,你需要一定的时间才能开始学习不是吗?
- 一定的数据结构基础(不必需)。可能你只需要知道树是什么东西就可以了。
- 一定的代码能力。对于自制编程语言而言,把原理变成实践的过程是一大障碍。
- 指针! 由于 C++ 的类和对象实在是太——烂——了——,在各种不知名的 OOP 的地方,会出现大量的指针引用、解引用、转换等,请务必理解指针再开始本文的阅读。
- 递归! 这个东西必须要会,除了词法分析以外的所有流程都有递归的参与,如果不会的话后续会很难推进。
好了,如果你确认以上的东西你都有的话,就可以正式开始自制编程语言的学习之旅了。
0x01 自制PL从空想到科学
由《编译原理》的目录可知,一个成熟的编译器是由词法分析、语法分析、语义分析、中间代码生成、符号表组织、运行时的存储组织与分配、代码优化及目标代码生成等各种玩意组成的。由于 CYaRon! 语的语法实在太过简单,语法分析和语义分析分不开,以下统称语法分析;而中间代码生成以后的这些东西是给成熟的编译器用的,我们的目标是切一道模拟,也不需要。
诶,这么一看,好像原本冗长的一本书就只剩下词法分析和语法分析了,真是magic!(逃)
词法分析:理解篇
什么是词法分析呢?我们以下面两行 CYaRon! 语代码为例:
{ vars
    chika:int
虽说读取源码读进来的是一整个字符串,但计算机可没有这么整体的思维,它只会把这个代码看成一个又一个的字符:{、v、a……该怎么让计算机知道,{ 其实是一个单独的整体,vars 也是一个整体,而中间那个空格不需要管呢?
事实上,把一个这么长的字符串拆成一个一个的整体的过程,就是词法分析。如果用图片来形象描述的话,大概就是这样一个过程:

在经历词法分析之后,它会被转化为这样几个整体:

除了剔除空格之外,包括剔除注释、剔除其他各种空白、处理转义这些工作,基本都是在词法分析这一阶段完成的。词法分析阶段以后,和代码执行本质无关的东西基本上就不存在了。
显然不同的整体会有不同的类型,但是相同类型的整体也不一定一致,比如 123 和 456 同为数字,却并不相同。如此看来,一个整体需要两个要素,一个是它的类型,一个是它的值。
每次都整体整体的叫,实在是太俗套了,我们 CSer(这里的 CS 指的是 Computer Science)需要高大上,怎么能用如此俗套的名字呢?不如就叫它 Token 好了,正好这词还有符号的意思,完全一致,就这么定了!
那么把这样一堆字符拆成一堆 Token 的意义何在呢?
我们以处理变量声明为例。仅就这道题而言,变量声明的结构还算简单,一个变量名,一个冒号,紧跟着就是类型,哪怕直接手撕字符流,也就只需要以下几步:扫一遍,扫到冒号后把前面的部分收集成变量名,然后判断冒号后的第一个字符是 i 还是 a,i 代表 int,a 代表 array,然后再进行后续的处理,看起来并不复杂。
现在假设 ltt 忽然被毒瘤附身,出了一道新题“CYaRon! 语 加强版”,出现了 double 这种新类型,那么手撕字符流的时候就需要多判断一种情况;假如再丧心病狂些支持了自定义类型,那这种逻辑就没法继续了。
然而,如果用 Token 的话,这种问题就不会存在,我管你什么 int、double、array,统统化成一个单独的 Token,哪怕有自定义类型,那也是一个 Token;然后在后续判断这个变量到底是什么类型的时候,就可以直接来看 Token,而不用一个一个地去看字符了。
好,现在如流水般的字符序列已经结成一坨一坨的 Token 了,对于计算机而言已经更好理解了一些。词法分析到此结束,我们向语法分析迈进。
语法分析:理解篇
相信各位在学习栈的时候一定学过一个经典案例:表达式求值。比如说:洛谷 P10473 表达式计算4
虽说这道题(以及类似的题目)的标准做法是栈,实际上让我写的话我也会去写栈,之所以在这里提到这样一道题,是因为这道题的知识点中还有另一个重要却被常常忽视的概念:表达式树。
引用题解区的一张图片,一棵表达式树通常长这样(这里是 (2+2)^(1+1) 的表达式树):
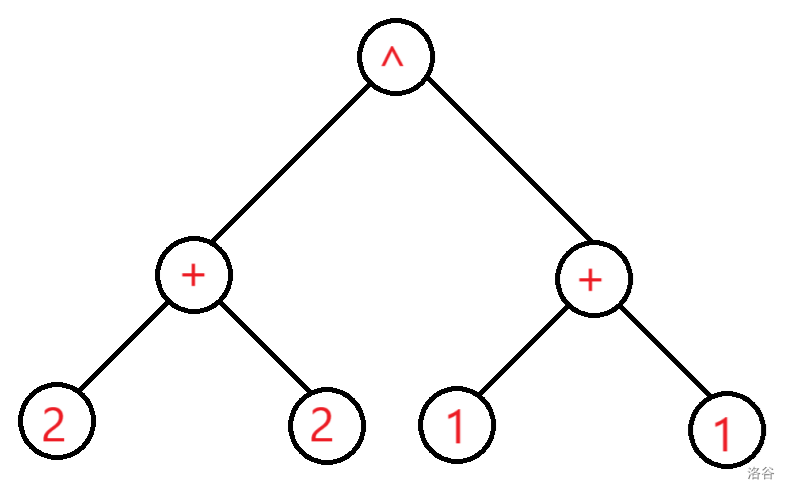
那么既然有栈就可以写了,还要表达式树干什么呢?因为表达式树的优点实在是太多了,包括但不限于:
- 通过树的节点关系可以轻松判断出运算的先后顺序,也就是说,优先级在这棵树上是很显然的;
- 构造这样一棵树并不很难,基本上和中缀转后缀的过程类似;
- 只需要遍历一遍这棵树就可以直接算出答案来,基本上算是离答案最为接近的形态了。
在自制编程语言的领域中,对表达式树稍作扩展,得到了一个更为丰富的东西:抽象语法树(Abstract Syntax Tree),简称 AST,这里可谓是编程语言界的兵家必争之地:进,可以继续向前,搞什么编译到字节码啦、直接让机器执行啦,包括翻译到 Python 这些活,从 AST 出发基本都是最优选(也不是没有狠人手撕 Token,不过难度有点大);退,也不是不可以作为最后一站,像表达式求值一样,通过遍历抽象语法树来直接执行代码。
CYaRon!语毕竟只是一道大模拟,又不是什么认真的自制编程语言,而且如果不在 AST 刹住的话,往后要考虑的事情就多了,所以我们就做到 AST 为止。也就是说,在语法分析之后,下一个流程就是执行了。
执行的话叫遍历也太俗套,当然它也有一个高大上的名字,名叫访问者模式,你写的遍历也有了新名字,叫做访问者(Visitor),不过这名字听上去还是太唐了,还是就叫遍历和执行好了。(其实两者还是略有区别的,访问者和访问者模式并没有执行的意思在,只是遍历而已)
这一节的内容大概就是这样,很简单吧?总结一下:
- 一个成熟的编译器流程是相当多的,但如果只想写个简单点的东西大部分都不需要。
- 词法分析就是把字符流弄成坨(Token)的过程,语法分析就是把一坨坨种成树(AST)的过程。
嘶,这一节好像什么都没讲呢?
\colorbox{green}{\color{white}\text{练习}}
能练习的部分真的有吗?
0x02 词法分析从理论到实践
刚才我们只是大概讲了一下词法分析大概是什么样的,现在我们来开始细说词法分析。
词法分析在实践上一般分为两种:一种使用正则表达式,好处是还算比较简单,而且较为公式化,如 Flex/lex 就使用类似正则表达式的方式进行词法分析的声明,高级应用还可以参见:56 行代码用 Python 实现一个 Flex/Lex。不过正则表达式的最大劣势就是在 C++ 中支持度实在太差,因此只能采用另一种方法——自动机法。没错,你将会在自制PL的过程中写出一个自动机!(逃)
注:本人对自动机也不是很了解,以下文本谨慎观看。
这个自动机的想法还是非常朴素的,我们以几种 Token 为例,简单思考一下分析方法:
- 单字符 Token,如
{、[、+等:这种非常简单,遇到它直接包装成一个 Token 就行。
- 简单多字符 Token,在这个语言里只有一个
..:如果遇到一个.就看下一个是不是.,如果是就包装成一个 Token,否则报错;
- 特殊多字符 Token,比如标识符(变量名、函数名和关键字统称标识符)/数字:一直向后,直到遇到不是字母或者数字的东西就停止收集;
- 注释:只要不是换行就一直跳过。
以上大概就是一个 CYaRon! 语词法分析器的逻辑,对上面的四类东西,我们来分步完成。
首先得定义一下 Token 是个什么东西,按照上面的描述,它是这样的一个东西:
代码 2-1 Token 为何物
struct Token {
    TokenType type; // 类型总共那么几种,用单独的类型存一下比较方便些
    string value; // 先用string存着,到时候需要了再临时转换,不差这点时间
public:
    Token(TokenType type, string value) : type(type), value(value) {}
};
看上去非常简单,实则一点也不复杂,这就是编程语言当中最为基本的元件——Token。
在对整个 CYaRon! 语的语法进行细致的阅读以后,我们最终将 CYaRon! 语的 Token 类型分为了以下几种:
代码 2-2 Token 的类型
enum TokenType {
// 单字符token
    TT_LBRACE, // {
    TT_RBRACE, // }
    TT_COMMA, // ,
    TT_LBRACKET, // [
    TT_RBRACKET, // ]
    TT_PLUS, // +
    TT_MINUS, // -
// 多字符token
    TT_DDOT, // ..
    TT_INTEGER, // 整数
    TT_IDENTIFIER, // 标识符
// 关键字
    TT_VARS,
    TT_INT,
    TT_ARRAY,
    TT_SET,
    TT_YOSORO,
    TT_IHU,
    TT_HOR,
    TT_WHILE,
    TT_LT,
    TT_GT,
    TT_LE,
    TT_GE,
    TT_EQ,
    TT_NEQ,
// 特殊token
    TT_ERROR, // 报错的时候报这个
    TT_EOF // 出现这个就说明token已经遍历完了
};
不多不少,正好 30 种,这个数量在一众编程语言中算相当少的,很多编程语言的关键字都不止 30 个。
那么想要词法分析,肯定需要有一段文本对吧,这段文本在哪呢?
答案是:先不管,这个部分放在最后的收尾部分。在后面的示例中,我们将会直接使用在题干中贴的那一长串 CYaRon! 语代码。
一个词法分析器需要接收一段文本,先这么写一下看看可不可以:
代码 2-3 词法分析器初步框架
struct Lexer {
private:
    string text;
    int pos;
    char current_char;
public:
    Lexer(string text) : text(text), pos(-1) {}
};
这个 pos 和 current_char 是干什么的呢?
前面已经说过,我们的词法分析器是一个自动机。而想要让自动机“动起来”,首先要明确这个自动机的状态是什么,怎么才算“动”。从前面的分析中可以看出来,当前字符是个很重要的东西,这个东西其实包含两个部分:当前(代表一个位置)以及字符(判定接下来是哪个 Token 的重要依据)。因此,想要改变它的状态,只需要移动当前字符对应的位置,并且更新对应的字符即可——这个操作在词法分析器中被称作 advance,即向前推进之意。
因此,这里提前添加好了这两个属性,之所以把 pos 的初值设置成 -1,是因为我们马上要进行一次 advance 操作:
代码 2-4 advance 的实现
struct Lexer {
private:
// 省略数据成员……
    void advance() {
        pos++;
        current_char = peek();
    }
    char peek() {
        if (pos >= text.size()) return 0;
        return text[pos];
    }
    char peekNext() {
        if (pos + 1 >= text.size()) return 0;
        return text[pos + 1];
    }
public:
    Lexer(string text) : text(text), pos(-1) {
        advance();
    }
};
除了 advance 本体外,还增加了获取当前字符和下一个字符的函数 peek 和 peekNext,这两个函数在处理 .. 时可能用得上,所以一并加进来了。
现在有了让自动机动起来的方案,是时候操控它真正去产生 Token 了。
代码 2-5 开始产出 Token
struct Lexer {
private: // ...
public:
    // Lexer(string text)
    vector<Token> make_tokens() {
        vector<Token> result;
        while (current_char) {
            // do something
        }
        result.push_back(Token(TT_EOF, "EOF"));
        return result;
    }
};
这里在最后添加了一个特殊的 Token:EOF,代表文件结束。
从易到难的话,首先是单字符的 Token:
代码 2-6 单字符 Token 的生成
struct Lexer {
// ...
        while (current_char) {
            if (current_char == '{') {
                result.push_back(Token(TT_LBRACE, "{"));
                advance();
            } else if (current_char == '}') {
                result.push_back(Token(TT_RBRACE, "}"));
                advance();
            } else if (current_char == '[') {
                result.push_back(Token(TT_LBRACKET, "["));
                advance();
            } else if (current_char == ']') {
                result.push_back(Token(TT_RBRACKET, "]"));
                advance();
            } else if (current_char == ',') {
                result.push_back(Token(TT_COMMA, ","));
                advance();
            } else if (current_char == '+') {
                result.push_back(Token(TT_PLUS, "+"));
                advance();
            } else if (current_char == '-') {
                result.push_back(Token(TT_MINUS, "-"));
                advance();
            }
        }
        // ...
};
这种 Token 的内在逻辑是完全一致的:找到字符--包成对应的 Token--advance,毕竟这一个字符就是它的全部了。
咦,这里是不是应该删掉一些代码当做练习?
接下来是处理双字符的 Token:..,它的逻辑略有不同。
代码 2-7 普通多字符 Token 的生成
struct Lexer {
// ...
        while (current_char) {
            // 单字符 Token 生成...
            else if (current_char == '.') {
                advance();
                if (peek() != '.') {
                    result.clear();
                    result.push_back(Token(TT_ERROR, "ERROR"));
                    return result;
                }
                result.push_back(Token(TT_DDOT, ".."));
                advance();
            }
        }
        // ...
};
整体的逻辑非常简单:跳过现在的 .,看接下来的字符是不是 .,如果是到话就包装成一个 Token,否则报错——这里的报错我采用了使用特殊 Token 的形式,方法不止一种,各位可自行探索。
接下来是一个特殊的字符:冒号,它出现在部分指令前以及变量声明中。然而,它的作用和空格其实并没有什么区别,所以我们把它当成空格处理即可。
再往下就该处理标识符和数字了,幸运的是,由于题目中给了限制(变量名全小写且无浮点数),这两个写起来都不太难。
代码 2-8 标识符和数字 Token 的生成
struct Lexer {
// ...
        while (current_char) {
            // 单字符 Token 生成...
            // 双字符 Token 生成...
            else if (isalpha(current_char)) {
                result.push_back(make_identifier());
            } else if (isdigit(current_char)) {
                result.push_back(make_digit());
            }
        }
        // ...
};
诶嘿,虚晃一枪好玩。我还是习惯把这种逻辑挪到单独的方法当中去,主循环里的逻辑尽可能精简。(..:幽默……)
以防有人不知道,这里的 isalpha 和 isdigit 函数来自头文件 <cctype>,是标准库的一部分,意义由函数名易得。
既然提到标识符,那就会不可避免地遇到关键字与变量名冲突这类问题。最省脑子的方法显然是:存一个 map 把关键字文本映射到对应的 Token 类型,然后对处理完的标识符看一看它在不在这个 map 里,如果在那就取出它对应的类型。
这个 map 无论在什么层面上都还不存在,快速进行一个初始化:
代码 2-9 关键字名称-TokenType 映射
map<string, TokenType> keywords;

struct Lexer {
private: // ...
public:
    Lexer(string text) // ...
    {
        // ...
        keywords["vars"] = TT_VARS;
        keywords["int"] = TT_INT;
        keywords["array"] = TT_ARRAY;
        keywords["set"] = TT_SET;
        keywords["yosoro"] = TT_YOSORO;
        keywords["ihu"] = TT_IHU;
        keywords["hor"] = TT_HOR;
        keywords["while"] = TT_WHILE;
        keywords["lt"] = TT_LT;
        keywords["gt"] = TT_GT;
        keywords["le"] = TT_LE;
        keywords["ge"] = TT_GE;
        keywords["eq"] = TT_EQ;
        keywords["neq"] = TT_NEQ;
    }
    // ...
};
现在终于能把标识符和数字这部分的代码写出来了:
代码 2-10 (真正的)标识符和数字 Token 生成
struct Lexer {
private:
    // 省略数据成员,advance,peek,peekNext
    Token make_identifier() {
        string name;
        while (isalpha(current_char)) {
            name += current_char;
            advance();
        }
        if (keywords.count(name)) return Token(keywords[name], name);
        return Token(TT_IDENTIFIER, name);
    }
    Token make_digit() {
        string num;
        while (isdigit(current_char)) {
            num += current_char;
            advance();
        }
        return Token(TT_INTEGER, num);
    }
public: // ...
}
这两个函数的逻辑几乎完全一致,只有返回时有少许区别。map 的 count 方法会返回对应的键是否存在,因此可以这样轻松分开关键字和非关键字。
最后,只剩下空白符和注释了。
代码 2-11 最后的收尾
struct Lexer {
// ...
        while (current_char) {
            // 单字符 Token 生成...
            // 双字符 Token 生成...
            // 标识符和数字...
            else if (current_char == ' ' || current_char == '\t' || current_char == '\n' || current_char == '\r' || current_char == ':') {
                advance();
            } else if (current_char == '#') {
                while (current_char != '\n') advance();
            } else {
                result.clear();
                result.push_back(Token(TT_ERROR, "ERROR"));
                return result;
            }
        }
        // ...
};
空白符应该没什么需要解释的,虽然冒号混在里面格格不入,但为什么这么干前面也解释了;最后的那个 else 就是保底,如果有不属于这里面字符里的任何一个那就报错。
注释的话,CYaRon! 语的注释均为单行注释,所以换行以前的东西通通不看即可。
至此,我们的词法分析器大功告成,在前进的道路上顺利行进了三分之一!鼓掌!!
把上面零散的 11 个代码片段拼成一个完整的词法分析器是需要时间和编程能力的(虽然只需要粘起来就行,也不需要写什么别的代码),那么给读者留作习题,参考答案见文末“完整代码”。
(我也知道这种行为很不道德,但是贴完整代码的话就又成水篇幅了……放心,语法分析虽然还是没完整代码,但是肯定会有测试的!)
\colorbox{green}{\color{white}\text{练习}}
- 拼图。 将上面的11个片段拼成一个完整的词法分析器,并自行编写测试,确认拼出来的东西可以工作。
- 优化。分析这种算法的时间复杂度,有什么改进的空间吗?
- 扩展。俗话说“人生苦短,我用 Python”,试用 Python 语言仿照文中思路写一个 CYaRon! 语的词法分析器。自行编写测试,确认它可以正常工作。
0x03 语法分析从一块到多块
好了,前面说过,语法分析的过程是什么玩意来着?是把一串 Token 流,搞成一棵抽象语法树(AST)。既然是一棵树,那肯定就要有节点,它的节点长什么样呢?
一句话概括:一种语句/表达式/字面量对应一种节点。例如,set 语句在我们的实现中对应 SetNode,加减法的表达式对应 BinOpNode,而整数则对应为 NumberNode(实现均见后)。
在 CYaRon! 语中,还有类型这种特殊的节点,它不属于上面三者的任何一种,却有必要写成单独的节点——这是为了后续求值时候的方便,具体为什么这么做到求值的时候再讲。
最终,依照出现顺序等要素,我们把 AST 的节点规划如下:
代码 3-1 AST 节点类型列表
enum NodeType {
    NODE_INT,
    NODE_ARRAY,
    NODE_VARDECL,
    NODE_YOSORO,
    NODE_NUMBER,
    NODE_SET,
    NODE_VARACCESS,
    NODE_BINOP,
    NODE_UNARYOP,
    NODE_STMTS,
    NODE_IHU,
    NODE_HOR,
    NODE_WHILE,
    NODE_ARRAYACCESS,
    NODE_ERROR
};
其中出现的节点大致可以分为几类:
- 类型(
int、array);
- 语句(变量声明
VarDecl、输出yosoro、变量赋值set、ihu、hor、while);
- 字面量(数字);
- 表达式(二元操作,即加、减
BinOp、一元操作,即取负数UnaryOp、变量读取VarAccess、数组读取ArrayAccess)。
除了特殊的报错节点以外,还有一个 Stmts 节点没法归类,事实上它的确也不需要存在,甚至有些多余——它的本意是代表语句的整体,但在实际执行时却常常要单独处理每一个语句,比如函数中的 return,循环中的 continue 和 break,因此它也就没什么用了,唯一的用途就是提供一个包括所有语句的根节点。
然而,这三种特殊情况在 CYaRon! 语中均不存在,所以我选择留它一命来行使它原本的职能。
表示这些节点的结构体总计长达 200 行,内容大部分都是重复的,我手打的时候差点没累死。总体而言,一个节点存放的内容就是它的所有“要素”,比如 BinOp 节点中就包括左操作数、右操作数两棵子树和运算符 Token,而数字节点中就只包括组成一个完整数字的 Token。
代码 3-2 AST 节点完整代码
struct BaseNode {
public:
    virtual ~BaseNode() {}
    virtual string tostring() = 0;
    virtual NodeType getType() = 0;
};

struct IntNode : public BaseNode {
public:
    virtual string tostring() {
        return "int";
    }
    virtual NodeType getType() {
        return NODE_INT;
    }
};

struct ArrayNode : public BaseNode {
    Token start, end;
public:
    ArrayNode(Token start, Token end) : start(start), end(end) {}
    virtual string tostring() {
        return string("int [") + start.value + ".." + end.value + "]";
    }
    virtual NodeType getType() {
        return NODE_ARRAY;
    }
};

struct VarDeclNode : public BaseNode {
    BaseNode *type;
    Token name;
public:
    VarDeclNode(BaseNode *type, Token name) : type(type), name(name) {}
    virtual ~VarDeclNode() { delete type; }
    virtual string tostring() {
        return type->tostring() + " " + name.value;
    }
    virtual NodeType getType() {
        return NODE_VARDECL;
    }
};

struct YosoroNode : public BaseNode {
    BaseNode *value;
public:
    YosoroNode(BaseNode *value) : value(value) {}
    virtual ~YosoroNode() { delete value; }
    virtual string tostring() {
        return string("print(") + value->tostring() + ")";
    }
    virtual NodeType getType() {
        return NODE_YOSORO;
    }
};

struct NumberNode : public BaseNode {
    Token num;
public:
    NumberNode(Token num) : num(num) {}
    virtual string tostring() {
        return num.value;
    }
    virtual NodeType getType() {
        return NODE_NUMBER;
    }
};

struct SetNode : public BaseNode {
    BaseNode *var, *val;
public:
    SetNode(BaseNode *var, BaseNode *val) : var(var), val(val) {}
    virtual ~SetNode() { delete var; delete val; }
    virtual string tostring() {
        return var->tostring() + " = " + val->tostring();
    }
    virtual NodeType getType() {
        return NODE_SET;
    }
};

struct VarAccessNode : public BaseNode {
    Token name;
public:
    VarAccessNode(Token name) : name(name) {}
    virtual string tostring() {
        return name.value;
    }
    virtual NodeType getType() {
        return NODE_VARACCESS;
    }
};

struct BinOpNode : public BaseNode {
    BaseNode *left, *right;
    Token op;
public:
    BinOpNode(BaseNode *left, Token op, BaseNode *right) : left(left), op(op), right(right) {}
    virtual ~BinOpNode() { delete left; delete right; }
    virtual string tostring() {
        return left->tostring() + " " + op.value + " " + right->tostring();
    }
    virtual NodeType getType() {
        return NODE_BINOP;
    }
};

struct UnaryOpNode : public BaseNode {
    BaseNode *node;
    Token op;
public:
    UnaryOpNode(BaseNode *node, Token op) : node(node), op(op) {}
    virtual ~UnaryOpNode() { delete node; }
    virtual string tostring() {
        return op.value + " " + node->tostring();
    }
    virtual NodeType getType() {
        return NODE_UNARYOP;
    }
};

struct StmtsNode : public BaseNode {
    vector<BaseNode *> stmts;
public:
    StmtsNode(vector<BaseNode *> stmts) : stmts(stmts) {}
    virtual ~StmtsNode() {
        for (int i = 0; i < stmts.size(); i++) delete stmts[i];
    }
    virtual string tostring() {
        string res;
        for (int i = 0; i < stmts.size(); i++) {
            res += "\n" + stmts[i]->tostring() + ";";
        }
        res += "\n";
        return res;
    }
    virtual NodeType getType() {
        return NODE_STMTS;
    }
};

struct IhuNode : public BaseNode {
    BaseNode *left, *right;
    Token cond;
    BaseNode *body;
public:
    IhuNode(BaseNode *left, Token cond, BaseNode *right, BaseNode *body)
      : left(left), cond(cond), right(right), body(body) {}
    virtual ~IhuNode() { delete left; delete right; delete body; }
    virtual string tostring() {
        return string("if (") + left->tostring() + " " + cond.value + " " + right->tostring() + ") {" + body->tostring() + "}";
    }
    virtual NodeType getType() {
        return NODE_IHU;
    }
};

struct HorNode : public BaseNode {
    BaseNode *var, *start, *end, *body;
public:
    HorNode(BaseNode *var, BaseNode *start, BaseNode *end, BaseNode *body)
      : var(var), start(start), end(end), body(body) {}
    virtual ~HorNode() { delete var; delete start; delete end; delete body; }
    virtual string tostring() {
        return "for (" + var->tostring() + " = " + start->tostring() + " to " + end->tostring() + ") {" + body->tostring() + "}";
    }
    virtual NodeType getType() {
        return NODE_HOR;
    }
};

struct WhileNode : public BaseNode {
    BaseNode *left, *right;
    Token cond;
    BaseNode *body;
public:
    WhileNode(BaseNode *left, Token cond, BaseNode *right, BaseNode *body)
      : left(left), cond(cond), right(right), body(body) {}
    virtual ~WhileNode() { delete left; delete right; delete body; }
    virtual string tostring() {
        return string("while (") + left->tostring() + " " + cond.value + " " + right->tostring() + ") {" + body->tostring() + "}";
    }
    virtual NodeType getType() {
        return NODE_WHILE;
    }
};

struct ArrayAccessNode : public BaseNode {
    Token name;
    BaseNode *index;
public:
    ArrayAccessNode(Token name, BaseNode *index) : name(name), index(index) {}
    virtual ~ArrayAccessNode() { delete index; }
    virtual string tostring() {
        return name.value + "[" + index->tostring() + "]";
    }
    virtual NodeType getType() {
        return NODE_ARRAYACCESS;
    }
};

struct ErrorNode : public BaseNode {
public:
    virtual string tostring() {
        return "ERROR";
    }
    virtual NodeType getType() {
        return NODE_ERROR;
    }
};
这里用到了大量的 C++ 类的有关知识,简单讲解一下:由于历史原因,C++ 的类设计和 Java、Python 等常见 OOP 语言差别巨大,如果方法前不带 virtual 的话,那么就相当于正常的函数,不参与 OOP 的多态之类的特性,所以在 tostring 与 getType 处带上了 virtual(因为这两个还是需要多态一下的,如果 getType 不多态,那么所有的节点都是同一种类型,如果 tostring 不多态,那么所有的节点对应的都是同一个字符串)。
另外,析构函数也是 virtual 的,这是因为每一个节点要释放的资源是不一样的,复杂的节点如 IhuNode 需要释放一堆子树,简单的节点如 NumberNode 没有需要释放的资源。
上面这 200 多行代码完全可以自己写一个代码生成器生成,但由于 CYaRon! 语规模较小,AST 节点较少,所以我没有写。
在实际开始写语法分析之前,我们来手动翻译一段代码作为一个 AST 的示例。由于 vector 在文档里不好表示,下面用 Python 里的列表等效替代。
题干里的样例太长,用下面给的样例 1 作为示例:
代码 3-3 一段示例 CYaRon! 语代码
{ vars
    a:int
    b:int
}

:set a, 1
:set b, 2
:yosoro a+b
首先,前面提到过,StmtsNode 是整个源码的根节点,所以先放一个根节点:
StmtsNode([
    ...
])
接下来,可以看到程序非常鲜明地分成两个部分:一个是 vars 对应的变量声明,一个是下面的三行命令,我们一个一个来看。
vars 作为一个语句块,自然也需要 StmtsNode,而里面的变量声明则对应的是 VarDeclNode(上面已经对每个节点对应什么东西进行了说明,不信你往上翻到代码 3-1 的下面):
StmtsNode([
    StmtsNode([
        VarDeclNode(Token(IDENTIFIER, 'a'), IntNode()),
        VarDeclNode(Token(IDENTIFIER, 'b'), IntNode())
    ]),
    ...
])
两块内容已经完成了一块,还有一块则分别处理(其实逻辑基本一样)。
首先是第一个 set,它翻译出来大概长这样:
SetNode(VarAccessNode(Token(IDENTIFIER, "a")), NumberNode(Token(INTEGER, "1")))
这里之所以要给 a 再套上一层 VarAccessNode,纯粹是为了区分变量和数组(两者都是用 set 命令进行赋值)。
那么同理可知,第二个 set 翻译出来就是这样的:
SetNode(VarAccessNode(Token(IDENTIFIER, "b")), NumberNode(Token(INTEGER, "2")))
最后这个输出自然对应 YosoroNode,而它的后面则是一个表达式 a+b,可进一步翻译为 BinOpNode,最后给两个变量各套上一个 VarAccess 即可。
YosoroNode(BinOpNode(VarAccessNode("a"), Token(PLUS, "+"), VarAccessNode("b")))
将上面三个语句扔进根节点,就得到了总体的 AST 如下:
StmtsNode([
    StmtsNode([
        VarDeclNode(Token(IDENTIFIER, 'a'), IntNode()),
        VarDeclNode(Token(IDENTIFIER, 'b'), IntNode())
    ]),
    SetNode(VarAccessNode(Token(IDENTIFIER, "a")), NumberNode(Token(INTEGER, "1"))),
    SetNode(VarAccessNode(Token(IDENTIFIER, "b")), NumberNode(Token(INTEGER, "2"))),
    YosoroNode(BinOpNode(VarAccessNode("a"), Token(PLUS, "+"), VarAccessNode("b")))
])
这样的输出实在不太好看,所以我们在 tostring 转字符串的时候做了相当的美化,把它变得像一个正常的代码一样:
int a;
int b;
;
a = 1;
b = 2;
print(a + b);
emm,虽说在输出的时候还是有些缺陷,不过已经看着非常正常了吧(心虚
在手动翻译完成之后,就可以正式开始语法分析器的制作了。我们的语法分析器也将是一个类似自动机的玩意,所以先快速地把词法分析器中的那几个好用的函数加进来:
代码 3-4 语法分析器开始
struct Parser {
private:
    vector<Token> tokens;
    int pos;
    Token current_tok;
    void advance() {
        pos++;
        if (pos >= tokens.size()) {
            current_tok = Token(TT_EOF, "");
            return;
        }
        current_tok = tokens[pos];
    }
    Token peek() {
        if (pos >= tokens.size()) return Token(TT_EOF, "");
        return tokens[pos];
    }
    Token peekNext() {
        if (pos + 1 >= tokens.size()) return Token(TT_EOF, "");
        return tokens[pos + 1];
    }
public:
    Parser(vector<Token> tokens) : tokens(tokens), pos(-1), current_tok(Token(TT_ERROR, "error")) {
        advance();
    }
};
语法分析本身也是一个相当大的命题,我们这版语法分析器还有另外一个或许没那么响当当的名字:递归下降解析器,那么,递归大家也许都能理解,下降是个什么鬼东西?
想要解释清楚这个问题,就得好好地解释解释诸如文法啦、终结符啦这种东西,这又变成一个相当大的坑了;不过这个东西是必须要讲清楚的,我尽量用不那么专业的语言进行简单的解释。
大家学英语的时候应该都学过各种各样的语法,单就一个句子而言,就可以分成主谓宾、主系表、双宾还能带上从句,总体而言那是一个繁复无比。不过总体而言,这些语法的主要目的,都是把原本的一个句子对应的一系列单词重新组合,然后变成更加易于我们大脑理解的东西——无论那是个什么东西,总之是向着对我们理解有利的方向迈出了一步。
诶,稍微对比一下我们就会发现,这个过程和语法分析蛮像的嘛!单词就是 Token,重新组合的过程就是语法分析,更加易于计算机理解的东西,不就是 AST 么?看来所谓的“文法”,也就是和英语的“语法”类似的东西。不仅如此,程序的文法还要更加简单一些:不管你之前和之后会写出什么样的代码,这一段代码的文法始终是一样的,我们称之为上下文无关文法;而英语的时态变化之类的玩意和上下文非常有关,并不属于上下文无关文法的范畴。
既然两者之间颇有相似之处,我们最好就得像英语一样,给程序划分出来,什么是主语,什么是谓语,什么是宾语,这之类的东西。然而,主语、谓语、宾语这种东西和“句子”“程序”一样,终究只是另一种形式的代词,这种类似的东西我们称之为非终结符,意思就是它可以被更加具体的东西替换;而有一些东西它是替换不了的,比如在分析数词的时候,数词其实就是各种数字的组合,那么这各种数字就无法再分,它们就是所谓的终结符,也就是最小的单元——Token。
现在也就终于可以解释递归下降里的下降到底是什么意思了,其实就是细分,把原来层次比较高的非终结符,代换成层次比较低的非终结符的组合(这个层次又是什么鬼?其实就是离终结符越近,层次就越低)。
编程语言的文法长什么样,是有一套固定的书写规则的,它被称为我也忘了总之是三个人名的某种神秘范式,简称BNF,再往里面小小地加一点正则,就变成了EBNF(其实正则含量并不大,主要就是添加了 ?、+ 和 *)。
我们来简单的分析一下 CYaRon! 语的语法。一个程序是由一堆语句组成的,因此一个语句自然应该是一个模块,按照 EBNF 的语法这么来写:
PROGRAM ::= STMT*
这里的 *,代表至少 0 个的意思。
接下来来具体处理语句。在 CYaRon! 语中,语句的种类相当丰富,包括 ihu、hor、while 、vars 这种复合语句以及 set 和 yosoro 这种单独的语句。尽管程序开头的 vars 部分似乎应该单独看待,但我还是选择把它也看成一种特殊的语句。
STMT ::= IHU_STMT | HOR_STMT | WHILE_STMT | SET_STMT | YOSORO_STMT | VARS_STMT
这里的 | 和 C++ 中一样,就是或的意思。
既然单独提了一嘴 vars,就从它先下手。一个 VARS 语句的开头是一个左大括号和一个 vars 关键字,然后是一大堆变量声明(至少一个,否则就不会有这个块了),最后是一个右大括号,表示如下:
VARS_STMT ::= <LBRACE> <VARS> VARDECL+ <RBRACE>
依照我本人的书写习惯,终结符两边我会选择加上尖括号 <>,否则就是可以进一步拆分的非终结符。这里的 +,代表前面的符号要出现至少 1 个。
而每一个变量声明则对应的是一个变量名和一个类型(冒号已在词法分析阶段删去):
VARDECL ::= <IDENTIFIER> TYPE
类型则又可分为两种,一种是 int,一种是 array[一个整数..另一个整数],由于有两种情况,中间用 | 来连接。
TYPE ::= <INT> | (<ARRAY> <LBRACKET> <INTEGER> <DDOT> <INTEGER> <RBRACKET>)
这里的 () 代表的是一个整体的意思,从 <ARRAY> 到 <RBRACKET> 构成一个完整的数组类型的定义。至此,vars 部分即可通过不断进行匹配的方式全部下降至终结符。所谓匹配就是把符合文法左边的部分给拆到文法右边,比如把一整个程序拆成一堆语句,也就是 STMT*,就是一次匹配的过程,一般而言要根据文法的右边来确定是否可以进行匹配。
接下来的语句都略有些复杂,因为它们会把表达式这种特殊的实体也牵扯进来。
和表达式最直接相关的应该就是 yosoro 语句了:
YOSORO_STMT ::= <YOSORO> EXPR
yosoro 语句的后面就是一个表达式,由于只用支持加和减,没有优先级问题,表达式解析起来相当简单:
EXPR ::= ATOM (<PLUS>|<MINUS> ATOM)*
这里的 () 代表的是一个整体的意思,也就是说这个整体(一个 + 或 - 再跟着一个 ATOM)会出现 0 次或多次。
而 ATOM 代表的就是在表达式中不可继续细分的东西,或者说优先级最高的东西。由于括号都不需要支持,ATOM 中只包括四个内容:一个整数、给一个同样是 ATOM 的东西取负号(-a[i]+5,显然得是 -a[i] 先算)、一个变量名或是一个对数组的访问。
ATOM ::= <INTEGER> | VAR_OR_ARRAY | <MINUS> ATOM
VAR_OR_ARRAY ::= <IDENTIFIER> (<LBRACKET> EXPR <RBRACKET>)?
由于“一个变量名或是一个对数组的访问”这种东西相当常见,所以这里单独包装了一个非终结符出来。? 代表出现 0 次或 1 次。
在这里就已经发生了一些有趣的递归现象了,理论上会出现 a[114+b[514+c[1919+d[810+e[19260+f[817+g[998244353+h]]]]]]] 这种东西,然后就会开始递归——不过名为题目描述的限制力告诉我们这种情况并不会存在。
表达式的部分到这里也就结束了,接下来的各类语句或许会水到渠成一些。首先是 set 语句,它把一个表达式赋值到一个变量名或数组取值:
SET_STMT ::= <SET> VAR_OR_ARRAY <COMMA> EXPR
然后是 ihu 和 while,两者的结构十分接近:
IHU_STMT ::= <LBRACE> <IHU> COND <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
WHILE_STMT ::= <LBRACE> <WHILE> COND <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
COND ::= <LT> | <GT> | <LE> | <GE> | <EQ> | <NEQ>
唯一的区别就在于关键字了吧。在题面里的代码中明确给出,先是一个操作符,然后是逗号,然后是表达式,然后是逗号,再往后又是表达式。目前来看所有的 ihu 和 while 语句中都是存在着至少一条语句的,因此选择了有相同意思的 + 放在 STMT 的后面。
最后一种语句是 hor,它把一个变量从一个表达式遍历到另一个表达式(从实际使用中推测可能还包括数组取值):
HOR_STMT ::= <LBRACE> <HOR> VAR_OR_ARRAY <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
至此,CYaRon! 语的大概语法就已经分析完毕了,总结一下就是这样的:
PROGRAM ::= STMT*
STMT ::= IHU_STMT | HOR_STMT | WHILE_STMT | SET_STMT | YOSORO_STMT | VARS_STMT
VARS_STMT ::= <LBRACE> <VARS> VARDECL+ <RBRACE>
VARDECL ::= <IDENTIFIER> TYPE
TYPE ::= <INT> | (<ARRAY> <LBRACKET> <INTEGER> <DDOT> <INTEGER> <RBRACKET>)
YOSORO_STMT ::= <YOSORO> EXPR
EXPR ::= ATOM (<PLUS>|<MINUS> ATOM)*
ATOM ::= <INTEGER> | VAR_OR_ARRAY | <MINUS> ATOM
VAR_OR_ARRAY ::= <IDENTIFIER> (<LBRACKET> EXPR <RBRACKET>)?
SET_STMT ::= <SET> VAR_OR_ARRAY <COMMA> EXPR
IHU_STMT ::= <LBRACE> <IHU> COND <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
WHILE_STMT ::= <LBRACE> <WHILE> COND <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
COND ::= <LT> | <GT> | <LE> | <GE> | <EQ> | <NEQ>
HOR_STMT ::= <LBRACE> <HOR> VAR_OR_ARRAY <COMMA> EXPR <COMMA> EXPR STMT+ <RBRACE>
这个时候某些聪明的读者就要问了:你光总结出来语法,那最多只算完成了一半呀,分析呢?落家里了?
事实上,语法分析的部分,只需要结合着 EBNF 然后对照着自己的树结构来看,那么就会非常简单!这就是递归下降解析器带给我的自信(
语法分析的基本流程,基本上就是把 EBNF 里出现在 ::= 左端的东西抄下来,然后分别写一个解析函数(有些太简单的比如说 TYPE 还有 COND 可以融合进其他函数里),最后在解析函数里实现各自的逻辑。
作为对外接口,我们提供一个 parse 函数用于正式开始语法分析。需要注意的是,由于我解题的时候并没有真的写一个 EBNF 出来,所以这里的代码写得比较乱,和上面的 EBNF 不一定对得上。
代码 3-5 对外接口
struct Parser {
private: // ...
public:
    // Parser(vector<Token> tokens)
    BaseNode *parse() {
        return parse_stmts();
    }
};
这里的 stmts 对应的是整个 EBNF 中的 STMT*,正好从这一条开始介绍把 EBNF 翻译到语法分析器当中的第一个原则?提示?我也不知道,就叫第一点吧:如果一个东西在 EBNF 中带 * 或者是带 +,那么必然对应一个对当前 Token 进行判断的 while 循环。
这个 while 循环的条件是什么呢?需要结合着语境来分析。首先,整个程序是一个大的 STMT*,所以要判断文件是否结束,也就是判断当前 Token 的类型是否为 EOF;其次,在解析语句块的时候也会用到 STMT*,这个多行语句是以 } 为结尾,所以还需要判断当前 Token 的类型是否为 }。
综上,这个 while 循环的条件,就是当前 Token 的类型不为 EOF,且不为 }。对于不同语法的编程语言,这一点可能不太相同,需要各位注意,在具体问题中需要进行具体的分析。
那么,一个 STMT 的处理逻辑是怎样的呢?是把它分成了 ihu 啦、set 啦这些不同的类型来进行分别判断的。其中,语句块(ihu、hor、while、vars)的第一个 Token 是 {,所以第一个 Token 总共有 {、set 和 yosoro 这三种类型,其余 Token 如出现则均可视为不合法。本质上讲,这个东西就是两个大的 switch-case:
代码 3-6 解析 STMT*
struct Parser {
private:
    // ...
    BaseNode *parse_stmts() {
        vector<BaseNode *> stmts;
        while (current_tok.type != TT_EOF && current_tok.type != TT_RBRACE) {
            if (current_tok.type == TT_LBRACE) {
                advance(); // 跳过左大括号,进一步分类
                switch (current_tok.type) {
                    case TT_VARS: {
                        BaseNode *node = parse_vars();
                        if (node->getType() == NODE_ERROR) return node;
                        stmts.push_back(node);
                        break;
                    }
                    case TT_IHU: {
                        BaseNode *node = parse_ihu();
                        if (node->getType() == NODE_ERROR) return node;
                        stmts.push_back(node);
                        break;
                    }
                    case TT_HOR: {
                        BaseNode *node = parse_hor();
                        if (node->getType() == NODE_ERROR) return node;
                        stmts.push_back(node);
                        break;
                    }
                    case TT_WHILE: {
                        BaseNode *node = parse_while();
                        if (node->getType() == NODE_ERROR) return node;
                        stmts.push_back(node);
                        break;
                    }
                    default:
                        for (int i = 0; i < stmts.size(); i++) delete stmts[i];
                        return new ErrorNode(); // 其他脏东西不应该出现
                }
            } else if (current_tok.type == TT_SET) {
                BaseNode *node = parse_set();
                if (node->getType() == NODE_ERROR) return node;
// 这里的处理其实不是很妥当,已经产生的AST节点尚未释放,但是它保证了不出错,我加报错纯粹为debug,所以有些地方也就不管这些细节了
//(但有些地方我就管的很多,所以emm)
                stmts.push_back(node);
            } else if (current_tok.type == TT_YOSORO) {
                BaseNode *node = parse_yosoro();
                if (node->getType() == NODE_ERROR) return node;
                stmts.push_back(node);
            } else {
                for (int i = 0; i < stmts.size(); i++) delete stmts[i];
                return new ErrorNode(); // +1
            }
        }
        return new StmtsNode(stmts);
    }
public: // ...
};
到最后,这些语句都被转发给了不同的分析函数。此时就可以总结第二点了:面对 EBNF 中大多数完全指定的终结符,先判断当前 Token 是不是这个终结符,不是则报错,是则跳过当前终结符。这是因为大部分终结符其实都是不需要的,只要保留要素即可。第三点则是:面对 EBNF 中的终结符,则需要调用对应的处理函数。至于对这一棵子树如何处理,则并没有什么定数,需要依据当前分析的节点类型而定。
在接下来的各种语句中,按照在 EBNF 当中的定义顺序,应当是 vars 最先:
代码 3-7 解析 vars
struct Parser {
private:
    // ...
    BaseNode *parse_vars() {
        advance();
        vector<BaseNode *> vardecl;
        while (current_tok.type == TT_IDENTIFIER) {
            Token name = current_tok;
            advance();
            BaseNode *type;
            if (current_tok.type == TT_INT) {
                advance();
                type = new IntNode();
            } else if (current_tok.type == TT_ARRAY) {
                advance();
                if (current_tok.type != TT_LBRACKET) return new ErrorNode();
                advance();
                if (current_tok.type != TT_INT) return new ErrorNode();
                advance();
                if (current_tok.type != TT_COMMA) return new ErrorNode();
                advance();
                Token start = current_tok;
                advance();
                if (current_tok.type != TT_DDOT) return new ErrorNode();
                advance();
                Token end = current_tok;
                advance();
                if (current_tok.type != TT_RBRACKET) return new ErrorNode();
                advance();
                type = new ArrayNode(start, end);
            }
            vardecl.push_back(new VarDeclNode(type, name));
        }
        if (current_tok.type != TT_RBRACE) return new ErrorNode();
        advance();
        return new StmtsNode(vardecl);
    }
public: // ...
}
VARDECL 和 TYPE 全部被整合进了 parse_vars 当中,毕竟这一部分实在是太简单了。首先跳过 vars 关键字,然后开始 while 循环,这里的判断条件是“当前 Token 为标识符(变量名)”,其实也可以写成“不是右大括号”。存完变量名跳过之后,就是对 TYPE 的解析,if-else 分别对应当前 Token 是 INT 和 ARRAY 的两种情况,INT 的话比较干脆,但是 ARRAY 由于装饰性的东西太多,所以要考虑的也就比较多,基本上每一个 Token 都做了判断,逻辑十分重复。在提取出来关键的起始和结束位置之后,就生成了对应的数组类型。把变量名和类型对应上之后就是一个完整的变量声明,加到结果里,最后用一个 StmtsNode 包装一下这一堆变量声明使得整个东西统一。
下面干什么呢?先来解析表达式吧,表达式的几个部分还是在相当广泛地被使用着。首先自然是 EXPR 本身:
代码 3-8 解析完整表达式
struct Parser {
private:
    // ...
    BaseNode *parse_expr() {
        BaseNode *node = parse_atom();
        if (node->getType() == NODE_ERROR) return node;
        while (current_tok.type == TT_PLUS || current_tok.type == TT_MINUS) {
            Token op = current_tok;
            advance();
            BaseNode *right = parse_atom();
            if (right->getType() == NODE_ERROR) {
                delete node; // 这个时候我还delete上了,难绷
                return right;
            }
            node = new BinOpNode(node, op, right);
        }
        return node;
    }
public: // ...
};
具体的逻辑与 EBNF 中相同,先解析一个 ATOM,然后是一个 while 循环,条件是当前 Token 是 + 或者 -(这是因为 EBNF 里明摆着写着 <PLUS>|<MINUS>),然后每一次都解析一个 ATOM 出来。由于是从左向右计算,所以在建树的时候,把原来的 node 当成左子树,新解析的 ATOM 当作右子树。
在解析 ATOM 的时候也就只需要按照上面的规则进行分类判断:
代码 3-9 解析 ATOM
struct Parser {
private:
    // ...
    BaseNode *parse_atom() {
        if (current_tok.type == TT_INTEGER) {
            Token num = current_tok;
            advance();
            return new NumberNode(num);
        } else if (current_tok.type == TT_IDENTIFIER) {
            return parse_var_or_array();
        } else if (current_tok.type == TT_MINUS) {
            Token op = current_tok;
            advance();
            BaseNode *node = parse_atom();
            if (node->getType() == NODE_ERROR) return node;
            return new UnaryOpNode(node, op);
        }
        return new ErrorNode();
    }
public: // ...
};
总共分成三块:整数、变量名或数组取值以及取负,取负的操作单独包上了一层 UnaryOpNode。
再然后就是变量名或数组取值了,同样的还是按照 EBNF 来写:
代码 3-10 解析变量名、数组取值
struct Parser {
private:
    // ...
    BaseNode *parse_var_or_array() {
        Token name = current_tok;
        advance();
        if (current_tok.type == TT_LBRACKET) {
            advance();
            BaseNode *index = parse_expr();
            if (index->getType() == NODE_ERROR) return index;
            if (current_tok.type != TT_RBRACKET) return new ErrorNode();
            advance();
            return new ArrayAccessNode(name, index);
        }
        return new VarAccessNode(name);
    }
public: // ...
};
在跳过了变量名后,如果是左中括号,那就说明是数组取值,需要单独进行一个解析;否则就是正常的变量取值,无需单独解析。
表达式解析完成之后,作为示例的 yosoro 语句也就很快出来了:
代码 3-11 解析 yosoro 语句
struct Parser {
private:
    // ...
    BaseNode *parse_yosoro() {
        advance();
        BaseNode *expr = parse_expr();
        return new YosoroNode(expr);
    }
public: // ...
};
因为 yosoro 语句实际上就是一个 yosoro 关键字加一个表达式,所以也只需要包装上一层 YosoroNode 就算是分析结束了。
代码 3-12 解析 set 语句
struct Parser {
private:
    // ...
    BaseNode *parse_set() {
        advance();
        BaseNode *var = parse_var_or_array();
        if (var->getType() == NODE_ERROR) return var;
        if (current_tok.type != TT_COMMA) return new ErrorNode();
        advance();
        BaseNode *val = parse_expr();
        if (val->getType() == NODE_ERROR) {
            delete var;
            return val;
        }
        return new SetNode(var, val);
    }
public: // ...
};
先跳过 set,然后解析一个变量名或数组取值,然后跳过一个逗号,最后解析一个表达式。在解析之后,把两个部分用一个 SetNode 包起来。
代码 3-13 解析 ihu 、while 语句
struct Parser {
private: // ...
    BaseNode *parse_ihu() {
        advance();
        Token condition = current_tok;
        if (condition.type != TT_LT && condition.type != TT_GT && condition.type != TT_LE && condition.type != TT_GE && condition.type != TT_EQ && condition.type != TT_NEQ) return new ErrorNode();
        advance();
        if (current_tok.type != TT_COMMA) return new ErrorNode();
        advance();
        BaseNode *left = parse_expr();
        if (left->getType() == NODE_ERROR) return left;
        if (current_tok.type != TT_COMMA) {
            delete left;
            return new ErrorNode();
        }
        advance();
        BaseNode *right = parse_expr();
        if (right->getType() == NODE_ERROR) {
            delete left;
            return right;
        }
        BaseNode *body = parse_stmts();
        if (body->getType() == NODE_ERROR) {
            delete left;
            delete right;
            return body;
        }
        if (current_tok.type != TT_RBRACE) {
            delete left;
            delete right;
            delete body;
            return new ErrorNode();
        }
        advance();
        return new IhuNode(left, condition, right, body);
    }
public: // ...
};
对 while 语句的解析和 ihu 相比只是最后返回的时候套的是 WhileNode 而非 IhuNode,因此不再重复。整个流程也是相当简单的,先跳过一个 ihu,然后判断条件是否是那六个其中之一,跳过逗号,解析表达式,跳过逗号,解析表达式,解析一整个语句块,最后跳过逗号。
最后一个是对 hor 语句的解析,整体上大同小异。
代码 3-14 解析 hor 语句
struct Parser {
private: // ...
    BaseNode *parse_hor() {
        advance();
        BaseNode *var = parse_var_or_array();
        if (var->getType() == NODE_ERROR) return var;
        if (current_tok.type != TT_COMMA) {
            delete var;
            return new ErrorNode();
        }
        advance();
        BaseNode *start = parse_expr();
        if (start->getType() == NODE_ERROR) {
            delete var;
            return start;
        }
        if (current_tok.type != TT_COMMA) {
            delete var;
            delete start;
            return new ErrorNode();
        }
        advance();
        BaseNode *end = parse_expr();
        if (end->getType() == NODE_ERROR) {
            delete var;
            delete start;
            return end;
        }
        BaseNode *stmts = parse_stmts();
        if (stmts->getType() == NODE_ERROR) {
            delete var;
            delete start;
            delete end;
            return stmts;
        }
        if (current_tok.type != TT_RBRACE) {
            delete var;
            delete start;
            delete end;
            delete stmts;
            return new ErrorNode();
        }
        advance();
        return new HorNode(var, start, end, stmts);
    }
public: // ...
};
逻辑上还是一样的,跳过一个 hor,然后解析变量名或数组取值,跳过逗号,解析表达式,跳过逗号,解析表达式,解析语句,最后跳过右大括号。
至此,语法分析的最后一块拼图也就拼完了,我们的语法分析器大功告成。
由于语法分析器就是由一个个函数组成的,所以拼装难度应该会明显小于词法分析器的拼装难度,同样的,具体细节留给读者自行拼装,给读者留作习题,参考答案见文末“完整代码”。
好了,现在假设各位读者的词法分析器和语法分析器都已经拼装完毕。上一节说了,本节要对词法分析器和语法分析器进行统一测试,怎么测试呢?首先需要一段测试文本,然后依次喂给词法分析器和语法分析器,如果能输出一棵 AST 来,且 AST 的字符串表示对应的伪代码和源代码意思相同,那就算是成功了。
鉴于 C/C++ 中表示多行字符串太过麻烦,这里把题面中的那一大段代码扔进一个文件 test.cyr,放在拼装成的一大段文件 main.cpp 的同一目录下。fstream 太过抽象,我没有使用,而是选择了使用 C 的文件访问 API。
代码 3-15 测试用 main
// ...
int main()
{
    FILE *fp = fopen("test.cyr", "rb"); // 打开test.cyr
    // 获取文件大小
    fseek(fp, 0, SEEK_END);
    long size = ftell(fp);
    // 读取文件
    fseek(fp, 0, SEEK_SET);
    char *buf = (char *) malloc(size + 5);
    fread(buf, size, 1, fp);
    // 进入分析流程
    Lexer l = Lexer(string(buf));
    vector<Token> t = l.make_tokens();
    if (t[0].type == TT_ERROR) {
        cout << "ERROR in lexing";
        return 0;
    }
    Parser p = Parser(t);
    BaseNode *root = p.parse();
    if (root->getType() == NODE_ERROR) {
        cout << "ERROR in parsing";
        return 0;
    }
    cout << root->tostring();
    return 0;
}
如果一切正确的话,输出应该如下:
int chika;
int you;
int [1..2] ruby;
int i;
;
print(2);
chika = 1;
you = 2;
print(chika + you);
if (chika eq 1) {
you = 3;
print(1);
};
for (i = 1 to you) {
print(i);
};
i = 1;
while (i le 2) {
print(i);
ruby[i] = i + 1;
print(ruby[i]);
i = i + 1;
};
虽然存在一些多余的分号,但是和源代码对比不难发现逻辑一致,那么我们的语法分析也就到此为止。
\colorbox{green}{\color{white}\text{练习}}
- 拼图。 将上面的14个片段拼成一个完整的语法分析器,并将测试用的
main加入,确认一切正常。 - 优化。分析这种算法的时间复杂度,有什么改进的空间吗?
- 扩展。试用 Python 语言仿照文中思路写一个 CYaRon! 语的语法分析器。自行编写测试,确认它可以正常工作。
0x04 执行:挡在AC路上的最后一块绊脚石
终于到了最后一步了。前面已经说过,所谓的执行,就是对这棵树进行一次遍历,然后在遍历的过程中对结果进行一次计算。
然而,与正常的表达式求值不同,在 CYaRon! 语中,出现了一种与 C++ 不同的数据类型:数组,它的主要特点是使用 start..end 而非 0..size。这种类型显然需要单独开一个类来处理。为了一致性起见,对于剩下的整数数据类型,以及用于填充返回值的 Null 数据类型,都需要单独包装成一个类,而非直接使用 C++ 的对应类型来处理。
事实上,哪怕所有类型都能表示为 C++ 的原版类型,我也会把所有的数据类型都包装成单独的类,原因大概如下:
- 方便扩展。添加一个新的数据类型只需要继承一下基类然后包装就行,没有必要从头开始把原来写好的 C++ 类型重新包装。
- 好写。由于 CYaRon! 语中出现了变量,因此需要做一个把变量名映射到目前的值的 map,如果全都用 C++ 类型的话,map 的值你打算给什么类型呢?
因此,就像 AST 节点一样,我们添加了一个 Value 类,作为所有这种自定义类型的总基类。同理,仍需要添加一个 enum 用于判断类型。
代码 4-1 所有自定义类型的总基类
// 数据类型,AST执行端用

enum ValueType {
    VALUE_INTEGER,
    VALUE_ARRAY,
    VALUE_NULL
};

struct Value {
public:
    virtual ~Value() {}
    virtual ValueType getType() = 0;
};
接下来最简单的类型应该是 Null 类型,因为真的啥也没有:
代码 4-2 最简单的 Null 类型
struct Null : public Value {
public:
    ValueType getType() {
        return VALUE_NULL;
    }
};
Integer 类型既要考虑从 Token 转化(NumberNode)又要考虑从 int 转化(初始值),因此代码较繁。
代码 4-3 Integer 类型
struct Integer : public Value {
private:
    int innerVal;
public:
    Integer(Token integer) : innerVal(0) {
        if (integer.type != TT_INTEGER) innerVal = 0;
        else {
            string s = integer.value;
            for (int i = 0; i < s.size(); i++) {
                innerVal = innerVal * 10 + s[i] - '0';
            }
        }
    }
    Integer(int innerVal = 0) : innerVal(innerVal) {}
    explicit operator int() {
        return innerVal;
    }
    Integer operator+(const Integer &other) const {
        return Integer(innerVal + other.innerVal);
    }
    Integer operator-(const Integer &other) const {
        return Integer(innerVal - other.innerVal);
    }
    virtual ValueType getType() {
        return VALUE_INTEGER;
    }
};
这里还实现了两个 Integer 之间的加法、减法以及和 int 之间的转换。
最后自然是数组类型,要存一头一尾(其实就本题而言只存开头就可以了)。
代码 4-4 Array 类型
struct Array : public Value {
private:
    int start, end;
    int *arrayBuf;
public:
    Array(Token start, Token end) {
        this->start = int(Integer(start));
        this->end = int(Integer(end));
        this->arrayBuf = new int[this->end - this->start + 5];
        memset(this->arrayBuf, 0, this->end - this->start + 1); // 题里规定初始值为0
    }
    virtual ~Array() { delete[] arrayBuf; }
    int &operator[](int index) {
        return arrayBuf[index - start];
    }
    virtual ValueType getType() {
        return VALUE_ARRAY;
    }
};
由于只会面临从 Token 初始化的情况,这里从 Integer 借来了转换到 int 的流程(我自己写会因未知原因 RE)。再往下的 int &operator[](int) 没什么重点,最重要的大概就是对引用的使用,用这样一个 trick 就可以实现 a[2] = 1 这种东西(更具体的细节属于 C++ 语法在本文不谈)。
最后需要添加一个 map,我们称之为符号表,用于保存当前时刻所有变量的值:
代码 4-5 符号表
map<Token, Value *> symbolTable;
注意 map 需要键之间实现小于和等于,随便实现一个即可:
代码 4-6 给 Token 补上比较运算符
struct Token {
    TokenType type; // 类型总共那么几种,用单独的类型存一下比较方便些
    string value; // 先用string存着,到时候需要了再临时转换,不差这点时间
public:
    Token(TokenType type, string value) : type(type), value(value) {}
    bool operator<(const Token &other) const {
        return value < other.value;
    }
    bool operator==(const Token &rhs) const {
        if (type != rhs.type) return false;
        if (type == TT_IDENTIFIER) return value == rhs.value;
        return true;
    }
};
至此,准备工作完成,可以正式开始执行了。注意:执行端我的码风非常抽搐,建议各位不要照搬,按照自己的思路仿写即可。
虽说在正文里我们还是叫执行和遍历,但是 visit 这个名字实在是太好用了,我也照搬过来:
代码 4-7 基本执行器框架
struct Interpreter {
public:
    Value *visit(BaseNode *node) { /* ... */ }
};
这个 visit 函数从本质上讲就是一个分发的过程,把不同类型的节点转发给不同的处理函数,具体而言是这样的:
代码 4-8 分发者 visit
struct Interpreter {
public:
    Value *visit(BaseNode *node) {
        switch (node->getType()) {
            case NODE_INT:
                return visit_IntNode(node);
            case NODE_ARRAY:
                return visit_ArrayNode(node);
            case NODE_VARDECL:
                return visit_VarDeclNode(node);
            case NODE_YOSORO:
                return visit_YosoroNode(node);
            case NODE_NUMBER:
                return visit_NumberNode(node);
            case NODE_SET:
                return visit_SetNode(node);
            case NODE_VARACCESS:
                return visit_VarAccessNode(node);
            case NODE_BINOP:
                return visit_BinOpNode(node);
            case NODE_UNARYOP:
                return visit_UnaryOpNode(node);
            case NODE_STMTS:
                return visit_StmtsNode(node);
            case NODE_IHU:
                return visit_IhuNode(node);
            case NODE_HOR:
                return visit_HorNode(node);
            case NODE_WHILE:
                return visit_WhileNode(node);
            case NODE_ARRAYACCESS:
                return visit_ArrayAccessNode(node);
            default:
                break;
        }
        return new Null();
    }
};
从这里就可以体现出把类型也处理成 AST 节点的高明之处了(希望你们还记得我前面挖的这样一个坑),那就是在真正处理的时候流程可以统一。其实还有另外一个比较抽象的好处,可以参考后面的代码自行体会。
既然说到了类型,那就先从类型开始。类型是作为变量声明这一个东西的附属物而存在的,所以把这三个连着一起说:
代码 4-9 整数类型、数组类型和变量声明语句的执行
struct Interpreter {
private:
    Value *visit_IntNode(BaseNode *node_) {
        return new Integer();
    }
    Value *visit_ArrayNode(BaseNode *node_) {
        ArrayNode *node = (ArrayNode *) node_;
        return new Array(node->start, node->end);
    }
    Value *visit_VarDeclNode(BaseNode *node_) {
        VarDeclNode *node = (VarDeclNode *) node_;
        symbolTable[node->name] = visit(node->type);
        return new Null();
    }
public: // ...
};
叫“整数类型、数组类型”的“执行”好像有点怪怪的,叫“访问”更抽象,叫“遍历”的话,我们的主语又不是节点,总之就是非常矛盾,所以还是把”执行“摆在这了。在这里就可以看出把类型处理成节点的另一个好处了,那就是可以在处理类型的时候声明一个单独的值,然后在变量声明时取值。
再往下应该处理的是和表达式有关的节点:
代码 4-10 表达式相关节点的计算
struct Interpreter {
private:
    // ...
    Value *visit_NumberNode(BaseNode *node_) {
        NumberNode *node = (NumberNode *) node_;
        return new Integer(node->num);
    }
    Value *visit_BinOpNode(BaseNode *node_) {
        BinOpNode *node = (BinOpNode *) node_;
        Integer *left = (Integer *) visit(node->left);
        Integer *right = (Integer *) visit(node->right);
        Integer *result;
        if (node->op.type == TT_PLUS) result = new Integer(*left + *right);
        else result = new Integer(*left - *right);
        delete left;
        delete right;
        return result;
    }
    Value *visit_UnaryOpNode(BaseNode *node_) {
        UnaryOpNode *node = (UnaryOpNode *) node_;
        Integer *num = (Integer *) visit(node->node);
        Integer *res = new Integer(Integer(0) - *num);
        delete num;
        return res;
    }
    Value *visit_VarAccessNode(BaseNode *node_) {
        VarAccessNode *node = (VarAccessNode *) node_;
        Value *val = symbolTable[node->name];
        return new Integer(*(Integer *) val);
    }
    Value *visit_ArrayAccessNode(BaseNode *node_) {
        ArrayAccessNode *node = (ArrayAccessNode *) node_;
        Integer *val = (Integer *) visit(node->index);
        Array *arr = (Array *) symbolTable[node->name];
        return new Integer((*arr)[int(*val)]);
    }
public: // ...
};
数字节点直接转化为 Integer 储存即可,双目和单目运算符节点则都要进行对应的计算,双目节点的类型是加就把左子树的结果和右子树的结果加起来,以此类推。由于 CYaRon! 语的单目运算符只有取负,所以就没做任何判断。再往下的变量和数组取值都要去符号表中找到对应的名字,然后再进行进一步的操作。
这里用到了相当多的诸如 new Integer(*(Integer *) val) 这种东西,这是因为这种计算的中间结果(包括最终结果)都是不需要的,所以在后面的语句执行(包括双目和单目运算的计算)完了会直接 delete 掉结果,如果不用这种方式复制一个指针的话,再进行变量取值的时候就什么都取不到了。
我们的主程序是一个 StmtsNode,所以需要先写一下这玩意的执行:
代码 4-10 语句块的执行
struct Interpreter {
private:
    // ...
    Value *visit_StmtsNode(BaseNode *node_) {
        StmtsNode *node = (StmtsNode *) node_;
        for (int i = 0; i < node->stmts.size(); i++) {
            delete visit(node->stmts[i]);
        }
        return new Null();
    }
public: // ...
};
其实没什么好说的,就是把每条语句依次执行,然后删除不必要的执行结果就可以了。
接下来是两个简单语句,yosoro 和 set 语句的执行:
代码 4-11 yosoro 和 set 语句的执行
struct Interpreter {
private:
    // ...
    Value *visit_YosoroNode(BaseNode *node_) {
        YosoroNode *node = (YosoroNode *) node_;
        Value *ret = visit(node->value);
        cout << int(*(Integer *) ret) << ' ';
        delete ret;
        return new Null();
    }
    Value *visit_SetNode(BaseNode *node_) {
        SetNode *node = (SetNode *) node_;
        Value *val = visit(node->val);
        if (node->var->getType() == NODE_VARACCESS) {
            VarAccessNode *vacn = (VarAccessNode *) node->var;
            delete symbolTable[vacn->name];
            symbolTable[vacn->name] = val;
        } else {
            ArrayAccessNode *aracn = (ArrayAccessNode *) node->var;
            Value *index = visit(aracn->index);
            Array *arr = (Array *) symbolTable[aracn->name];
            (*arr)[int(*(Integer *)index)] = int(*(Integer *) val);
            delete index;
        }
        return new Null();
    }
public: // ...
};
我的天哪,这简直是一坨美妙的大奋!让我们一起来赤石罢!(喜)
yosoro 语句相对简单,就是计算它里面携带的表达式并输出,唯一要注意的就是输出的格式问题,要求的是末尾空格而非换行。
而 set 语句,我不好评价啊,我不好说。首先计算出要把这个东西赋成什么值,然后根据要赋给什么东西进行分类讨论。如果要赋给一个变量,那就比较简单,先把原来的值 delete 掉,再赋上新值即可。如果要赋给一个数组,那就再计算出要访问哪个地方,然后把值填进去就行(为了节省代码长度,这里又用了一堆非常美妙的指针)。
在剩下的部分当中,ihu 语句的执行其实要更加简单一些,因为它不需要时时刻刻维护变量的值:
代码 4-12 ihu 语句的执行
struct Interpreter {
private:
    // ...
    Value *visit_IhuNode(BaseNode *node_) {
        IhuNode *node = (IhuNode *) node_;
        Integer *left = (Integer *) visit(node->left);
        Integer *right = (Integer *) visit(node->right);
        int lval = int(*left);
        int rval = int(*right);
        delete left;
        delete right;
        if ((node->cond.type == TT_LT && lval < rval) || (node->cond.type == TT_GT && lval > rval) || (node->cond.type == TT_LE && lval <= rval) ||
          (node->cond.type == TT_GE && lval >= rval) || (node->cond.type == TT_EQ && lval == rval) || (node->cond.type == TT_NEQ && lval != rval)) {
            delete visit(node->body);
        }
        return new Null();
    }
public: // ...
};
O M G。最主要的部分是中间那一个大 if,它的职责就是把 ihu 语句中需要比较的两个值进行比较,如果结果与 ihu 语句的条件刚好可以匹配的话,那么就执行中间的大语句块,否则就不执行。
while 语句的结构与之类似,但要维护变量的当前值,所以略微有些复杂:
代码 4-13 while 语句的执行
struct Interpreter {
private:
    // ...
    Value *visit_WhileNode(BaseNode *node_) {
        WhileNode *node = (WhileNode *) node_;
        Integer *left = (Integer *) visit(node->left);
        Integer *right = (Integer *) visit(node->right);
        int lval = int(*left);
        int rval = int(*right);
        delete left;
        delete right;
        while ((node->cond.type == TT_LT && lval < rval) || (node->cond.type == TT_GT && lval > rval) || (node->cond.type == TT_LE && lval <= rval) ||
          (node->cond.type == TT_GE && lval >= rval) || (node->cond.type == TT_EQ && lval == rval) || (node->cond.type == TT_NEQ && lval != rval)) {
            delete visit(node->body);
            left = (Integer *) visit(node->left);
            right = (Integer *) visit(node->right);
            lval = int(*left);
            rval = int(*right);
            delete left;
            delete right;
        }
        return new Null();
    }
public: // ...
};
虽然但是,其实并没有增加多少代码,只是最下面多了几行更新 lval 和 rval 的东西,这纯粹是 while 循环体会更改变量值的缘故。
最后就是 hor 语句了:
代码 4-14 hor 语句的执行
struct Interpreter {
private:
    // ...
    Value *visit_HorNode(BaseNode *node_) {
        HorNode *node = (HorNode *) node_;
        Integer *start = (Integer *) visit(node->start);
        Integer *end = (Integer *) visit(node->end);
        int startval = int(*start);
        int endval = int(*end);
        delete start;
        delete end;
        for (int i = startval; i <= endval; i++) {
            if (node->var->getType() == NODE_VARACCESS) {
                VarAccessNode *vacn = (VarAccessNode *) node->var;
                delete symbolTable[vacn->name];
                symbolTable[vacn->name] = new Integer(i);
            } else {
                ArrayAccessNode *aracn = (ArrayAccessNode *) node->var;
                Value *index = visit(aracn->index);
                Array *arr = (Array *) symbolTable[aracn->name];
                (*arr)[int(*(Integer *)index)] = i;
                delete index;
            }
            delete visit(node->body);
        }
        return new Null();
    }
public: // ...
};
hor 语句的一大特点是 start 和 end 不变而变量值一直在变,所以每一轮循环都要更新变量的当前值。这又与 while 不一样了,while 需要的是频繁的读取,而 hor 需要的是频繁地往符号表里写入。中间写入的这一部分是偷的 SetNode 的代码,具体解释可以看看上面 set 语句的执行。
至此,CYaRon! 语所有 AST 已经全部得到执行,鼓掌!(啪啪啪
但是,AST 都得到执行并不意味着万事大吉。距离 AC 这道题,还差最后一个部分——输入。
其实,这个语言的输入非常简单(想不到吧!):直接一直 getchar,直到读到 EOF 即可。最后,把这些字符拼成一个 string ,然后依次扔给词法分析器、语法分析器和执行器:
代码 4-15 main 函数
int main()
{
    cin.tie(0); cout.tie(0);
    string content;
    char ch;
    while ((ch = getchar()) != -1) content += ch;
    Lexer l = Lexer(content);
    vector<Token> tokens = l.make_tokens();
    if (tokens[0].type == TT_ERROR) {
        cout << "ERROR in lex\n";
        return 0;
    }
    Parser p = Parser(tokens);
    BaseNode *root = p.parse();
    if (root->getType() == NODE_ERROR) {
        cout << "ERROR in parse\n";
        delete root;
        return 0;
    }
    cout << root->tostring();
    Interpreter interp;
    delete interp.visit(root);
    delete root;
    return 0;
}
到此为止,整个程序才算是编写完成。把这些代码妥善地拼接在一起就可以 AC 啦!
完整代码参见:洛谷云剪贴板
\colorbox{green}{\color{white}\text{练习}}
- 拼图。 将上面的片段拼成一个完整的执行器,并与前面拼成的词法分析器、语法分析器一起,形成一个完整的可以 AC 的程序。请自行参照上方完整代码。
- 优化。 本节代码似乎有些过于依赖递归了,你能找到优化的方法吗?
- 拓展。 试用 Python 语言仿照文中思路写一个 CYaRon! 语的执行器。自行编写测试,确认它可以正常工作。已知可以通过
source = sys.stdin.read()的方式将标准输入完整读入到变量source中,试着与前面所有的部分结合起来,用 Python3 AC 本题。可恶,我本来能抢到 Python3 首杀的,但是正则表达式太强了啊啊啊啊
0x05 一些简单扩展:四则运算与字符串
完整的四则运算支持
题解的部分到这里已经结束了,如果你是奔着这道题来的,那么大可以就此关闭这篇博客,然后去学习一些更加有用的字符串算法了。如果你真的还想学自制编程语言的话,那么推荐在看完这篇博客之后,继续看看后面给的参考文献。
在最开头的时候,我提到用 CYaRon! 语做示例的原因是它简单。但写完了之后再回顾,它好像又太简单了,四则运算都没支持完,这就导致如果真正要做编程语言,你会在优先级的问题上无从下手。
既然如此,这里还是简单地把四则运算补全,讲一讲加减乘除吧。我们抛掉一切的其他东西了,专门来分析四则运算。
首先,假设 EXPR 是表示整个四则运算表达式的东西(我们暂且不考虑它里面究竟是个什么东西)。为了简便起见,我们按优先级从高到低的顺序进行分析。
在四则运算中,优先级最高的应该是以下几个东西:括号、对一个最高优先级的东西直接取负以及整数本身。用 EBNF 的语言表示一下,大概是长这样的:
ATOM ::= (<LPAREN> EXPR <RPAREN>) | (<MINUS> ATOM) | <INTEGER>
接下来怎么办呢?由于乘除优先级高,所以先处理乘除:
TERM ::= ATOM ((<MUL>|<DIV>) ATOM)*
这个实际上就是从前面 CYaRon! 语的表达式里把运算符给改了。之所以用 TERM 而不是直接用 EXPR,是因为在数和加减之间,显然需要一个乘除来做中间层。
最后终于到了最为棘手的加减。这里需要注意的是,TERM 不仅可以表示任意多个数之间的乘除,也可以单独表示一个数本身,只要让这个数匹配 ATOM,然后后面的 * 取 0 个即可。
由于乘除运算的优先级比加减高,故可以把乘除运算看成一个整体。把单个的数也变成 TERM 以后我们发现,EXPR 实际上就是在对一堆 TERM 进行加减运算。也就是说,只需要把上面代码里的 TERM 改成 EXPR,ATOM 改成 TERM,再把运算符改一改,就得到了四则运算的 EBNF 表示:
EXPR ::= TERM ((<PLUS>|<MINUS>) TERM)*
TERM ::= ATOM ((<MUL>|<DIV>) ATOM)*
ATOM ::= (<LPAREN> EXPR <RPAREN>) | (<MINUS> ATOM) | <INTEGER>
(注:尽管最经典的版本使用的非终结符符号是 expr-term-factor,但为了上下文一致性,这里使用 ATOM 替代了 factor。)
好了,现在四则运算的部分就已经分析完毕了,如何把这些东西移入 CYaRon! 语呢?
首先,由于出现了新的字符(*、/、(、))以及对应的新 Token,词法分析器是必须要修改的,不过由于只添加了四个单字符 Token,修改起来并不麻烦:
代码 5-1 四则运算:词法分析部分的修改
enum TokenType {
// 单字符token
// ...
    TT_PLUS,
    TT_MINUS,
    TT_MUL,
    TT_DIV,
    TT_LPAREN,
    TT_RPAREN,
// 省略其余部分
};

// struct Token

struct Lexer {
private: // ...
public:
    // Lexer(string text)
    vector<Token> make_tokens() {
        // ...
        while (current_char) {
            // ...
            } else if (current_char == '-') {
                result.push_back(Token(TT_MINUS, "-"));
                advance();
            } else if (current_char == '*') { // 新增部分从这里开始
                result.push_back(Token(TT_MUL, "*"));
                advance();
            } else if (current_char == '/') {
                result.push_back(Token(TT_DIV, "/"));
                advance();
            } else if (current_char == '(') {
                result.push_back(Token(TT_LPAREN, "("));
                advance();
            } else if (current_char == ')') {
                result.push_back(Token(TT_RPAREN, ")"));
                advance();
            } else if (current_char == '.') { // 新增部分到这里结束
            // ...
        }
    }
};
好吧,虽然嘴上说着并不麻烦,但是细节好像也不少,由于出现了新的 Token,TokenType 也要跟着改。
由于乘法和除法都是二元运算,可以沿用 BinOpNode,所以不出现新的 AST 节点。
语法分析部分的修改也没什么好说,像以前一样套公式就可以了。需要注意的无非就是,ATOM 要在我们分析的四则运算的基础上与原先的 ATOM 求并。
代码 5-2 四则运算:语法分析部分的修改
struct Parser {
private:
    // ...
    BaseNode *parse_atom() {
        // ...
        } else if (current_tok.type == TT_LPAREN) { // 从这里开始是新增的部分
            advance();
            BaseNode *node = parse_expr();
            if (node->getType() == NODE_ERROR) return node;
            if (current_tok.type != TT_RPAREN) return new ErrorNode();
            advance();
            return node;
        } // 新增的部分到此结束
        return new ErrorNode();
    }
    // 下面整个函数都是新写的
    BaseNode *parse_term() {
        BaseNode *node = parse_atom();
        if (node->getType() == NODE_ERROR) return node;
        while (current_tok.type == TT_MUL || current_tok.type == TT_DIV) {
            Token op = current_tok;
            advance();
            BaseNode *right = parse_atom();
            if (right->getType() == NODE_ERROR) {
                delete node;
                return right;
            }
            node = new BinOpNode(node, op, right);
        }
        return node;
    }
public: // ...
};
parse_expr 的修改非常直接,只需要把其中的 parse_atom 修改为 parse_term 即可。其实还可以封装成一个专门处理二元操作的函数,更为直观些,不过在目前来看很不需要就是了。
结束了么?不,执行的部分还需要修改。在求值 BinOpNode 的时候,需要算上新的乘法和除法运算符:
代码 5-3 四则运算:执行部分的修改
struct Integer {
private: // ...
public:
    // ...
    // 以下是为了方便新增的部分
    Integer operator*(const Integer &other) const {
        return Integer(innerVal * other.innerVal);
    }
    Integer operator/(const Integer &other) const {
        return Integer(innerVal / other.innerVal);
    }
};

// ...

struct Interpreter {
private:
    // ...
    Value *visit_BinOpNode(BaseNode *node_) {
        BinOpNode *node = (BinOpNode *) node_;
        Integer *left = (Integer *) visit(node->left);
        Integer *right = (Integer *) visit(node->right);
        Integer *result;
        if (node->op.type == TT_PLUS) result = new Integer(*left + *right);
        else if (node->op.type == TT_MINUS) result = new Integer(*left - *right); // 这里做了修改
        else if (node->op.type == TT_MUL) result = new Integer(*left * *right); // 这里是新增的
        else if (node->op.type == TT_DIV) result = new Integer(*left / *right); // 这里是新增的
        delete left;
        delete right;
        return result;
    }
    // ...
public: // ...
};
于是到此为止,我们就可以正常的进行四则运算了,可以自行编写程序测试。作为参考,下面是我进行测试的 CYaRon! 语代码:
{ vars
    a:int
    b:int
}

:set a, 1
:set b, 2
:yosoro a + b
:yosoro a - b
:yosoro a * b
:yosoro a / b
:yosoro a + b * b
:yosoro (a + b) * b
输出应为 3 -1 2 0 5 6。
为了支持四则运算,我们一共在原有代码的基础上添加了大约 40 行代码,而一个中缀转后缀大约需要 80 行,体现了我们这种方法的极大优越性和扩展性(?)
这么一看,四则运算好像也并不困难,可能对于某些思维非常强大的 OIer 而言,这种扩展都是显然的。
从0.05开始添加字符串
那么就来点不那么显然的东西吧,我们来为这个语言添加字符串。在设想中,字符串的使用应该大概类似下面这样:
{ vars
    a:str
}

:set a, "123456789"
:yosoro a[i]
添加字符串是一个相当大的课题,这意味着我们的词法分析要修改、语法本身要修改、语法分析要修改、执行更要修改,由于添加了一种新的数据类型,更是要同步修改 AST 节点以及那几种数据类型,可谓是牵一发而动全身了。按照前面讲的顺序,我们一步一步来,从词法分析开始。
为方便实现,我们只支持双引号开头的单行字符串,例如 "Hello, World!" "Luogu Boom Daily" 都是合法的字符串,但是 'Is This Legal?' 就是不合法的字符串。转义字符也不进行过多实现,暂时只实现 \n、\t 和 \b。
这一部分显然已经复杂到需要在词法分析器中单独开一个函数来实现,先在大循环中加一个进入函数的接口:
代码 5-5 字符串:词法分析部分的修改(TokenType、主循环)
enum TokenType {
// ...
// 多字符 Token
    TT_DDOT,
    TT_INTEGER,
    TT_IDENTIFIER,
    TT_STRING, // 这里是新增的部分
// 关键字
    TT_VARS,
    TT_INT,
    TT_ARRAY,
    TT_STR, // 这里是新增的部分
    TT_SET,
// 省略其余部分
};

// struct Token

struct Lexer {
private: // ...
public:
    Lexer(string text) : text(text), pos(-1) {
        // ...
        keywords["str"] = TT_STR; // 新增一行这个
        // ...
    }
    vector<Token> make_tokens() {
        // ...
        while (current_char) {
            // ...
            } else if (isdigit(current_char)) {
                result.push_back(make_digit());
            } else if (current_char == '"') { // 新增部分从这里开始
                Token t = make_string();
                if (t.type != TT_ERROR) result.push_back(t); // 为什么要这么搞呢?参见后文哦
                else {
                    result.clear();
                    result.push_back(t);
                    return result;
                } // 新增部分到这里结束
            } else if (current_char == ' ' || current_char == '\t' || current_char == '\n' || current_char == '\r') {
            // ...
        }
    }
};
除去添加了新的函数以外,由于希望把字符串当做整体处理成单独的 Token,所以添加了一个新的 Token 类型。
make_string 函数在实现上细节极多,我自己写的时候都写错两遍,请参考注释理解:
代码 5-6 字符串:词法分析部分的修改(make_string 函数)
struct Lexer {
private:
    // ...
    Token make_string() {
        string str; // 存字符串的东西
        bool is_after_backslash = false; // 当前字符是否转义?
        advance(); // 跳过第一个引号
        while (current_char && current_char != '\n' && (current_char != '"' || is_after_backslash)) { // 当前字符首先不是\0(已结束),然后不是回车,再其次不是引号(字符串结束)或属于转义
            // 这样遇到\"的时候不会错误地提前结束
            if (is_after_backslash) { // 如果说是转义
                switch (current_char) { // 手动处理
                    case 'n': // \\n -> \n,然后加到字符串里
                        str += '\n';
                        break;
                    case 'b': // \\b -> \b,然后加到字符串里
                        str += '\b';
                        break;
                    case 't': // \\t -> \t,然后加到字符串里
                        str += '\t';
                        break;
                    default: // \\ -> \, \" -> ",然后加到字符串里
                        str += current_char;
                        break;
                } // 显然上面的转义不全,请聪明的读者自行思考如何扩展
                is_after_backslash = false; // 现在不属于转义了
                advance(); // 下一个字符
                continue; // 跳过后续处理
            }
            if (current_char == '\\') { // 如果当前字符是反斜杠
                is_after_backslash = true; // 下一个字符属于转义
                advance(); // 跳过当前字符
                continue; // 跳过后续处理
            } else str += current_char; // 否则就原样添加
            advance(); // 跳到下一个字符
        }
        if (!current_char || current_char == '\n') { // 已经行末了/文件都结束了,字符串还没结束,这不善
            return Token(TT_ERROR, "ERROR"); // 返回ERROR
        }
        advance(); // 跳过结尾引号
        return Token(TT_STRING, str); // 返回当前Token
    }
public: // ...
};
至此,字符串已经可以在词法阶段被识别,化为了终结符 <STRING>。下面来考虑怎么将字符串纳入语法的问题。
从一方面来讲,字符串的表现其实非常像数组:在赋值给同一个变量之后,都是用 [] 来进行取值的。但是,单独的一个 "XXXX" 应该放在哪里呢?就我个人而言,我还是更希望支持这种东西的:
:set h, "abcdefgh"[7]
也就是说,字符串后面可以像正常的数组一样接上中括号直接取索引。而无论是取索引之前还是之后,它都应该被当做一个最基本的、应当“优先计算”的单元来看——也就是应该被放进 ATOM 里。
然后再考虑怎么把它变成节点的问题。显然,这两种东西应该对应两种不同的节点,因此我创建了 StringNode 和 StringElementNode:
代码 5-7 字符串有关的新节点
enum NodeType {
    // ...
    NODE_STRING,
    NODE_STRINGELEMENT,
    // ...
};

// ...

struct StringNode : public BaseNode {
    Token str;
public:
    StringNode(Token str) : str(str) {}
    virtual string tostring() {
        return "\"" + str.value + "\"";
    }
    virtual NodeType getType() {
        return NODE_STRING;
    }
};

struct StringElementNode : public BaseNode {
    Token str;
    BaseNode *ind;
public:
    StringElementNode(Token str, BaseNode *ind) : str(str) {}
    virtual ~StringElementNode() { delete ind; }
    virtual string tostring() {
        return "\"" + str.value + "\"[" + ind->tostring() + "]";
    }
    virtual NodeType getType() {
        return NODE_STRINGELEMENT;
    }
};
分别对应对一个字符串啥也不干和取元素的两种行为。
把 parse_var_or_array 的代码照搬,改一下返回的节点类型,并添加到 parse_atom 中,我们就完成了对字符串的语法分析:
代码 5-8 对字符串的语法分析
struct Parser {
private:
    // ...
    BaseNode *parse_atom() {
        // ...
        } else if (current_tok.type == TT_STRING) { // 从这里开始是新增的部分
            Token name = current_tok;
            advance();
            if (current_tok.type == TT_LBRACKET) {
                advance();
                BaseNode *index = parse_expr();
                if (index->getType() == NODE_ERROR) return index;
                if (current_tok.type != TT_RBRACKET) return new ErrorNode();
                advance();
                return new StringElementNode(name, index);
            }
            return new StringNode(name);
        }
        // ...
    }
public: // ...
};
真的是完全照搬,一模一样,可自行与前文对照。
在变量声明的部分,也要加上对 TT_STR 的判断,为了偷懒,这里就生成一个空白的 StringNode:
代码 5-9 给变量声明打个补丁
struct Parser {
private:
    // ...
    BaseNode *parse_vars() {
            // ...
            } else if (current_tok.type == TT_STR) { // 新增的部分从这里开始
                type = new StringNode(Token(TT_STRING, ""));
                advance();
            } // 新增的部分到这里结束
            vardecl.push_back(new VarDeclNode(type, name));
        }
        // ...
    }
};
现在,字符串有关的语法分析就已经完成了,如果现在编译运行并测试的话,除了一个段错误以外什么也得不到。
最后就是执行的部分。现在,想要执行需要改动相当多的地方:不仅仅要添加两个 visit 方法,而且还要添加一个新的数据类型,以及要对之前已有的扩展性不佳的 ihu 和 hor 部分进行修改。
首先,添加一个 String 类型作为包装:
代码 5-10 新数据类型:字符串
enum ValueType {
    VALUE_INTEGER,
    VALUE_ARRAY,
    VALUE_STRING,
    VALUE_NULL
};

// ...

struct String : public Value {
    string str;
    char royalzero; // 不用这个的话,下面的char &会疯狂报错
public:
    String(Token str) : royalzero(0) {
        this->str = str.value;
    }
    char &operator[](int index) {
        return (index >= 0 && index < str.size() ? str[index] : royalzero);
    }
    virtual ValueType getType() {
        return VALUE_STRING;
    }
};
为了实现简单起见,就不添加字符型了(否则还要考虑字符串转换一类的东西)。对于超出字符串长度的部分直接返回 0,是为了程序能够计算字符串长度的考虑。
然后来创建访问 StringNode 和 StringElementNode 的方法:
代码 5-11 对新节点的访问
struct Interpreter {
private:
    // ...
    Value *visit_StringNode(BaseNode *node_) {
        StringNode *node = (StringNode *) node_;
        return new String(node->str);
    }
    Value *visit_StringElementNode(BaseNode *node_) {
        StringElementNode *node = (StringElementNode *) node_;
        string str = node->str.value;
        Integer *index = (Integer *) visit(node->ind);
        int ind = int(*index);
        delete index;
        return new Integer(str[ind]);
    }
public:
    Value *visit(BaseNode *node) {
        switch (node->getType()) {
            // ...
            case NODE_STRING:
                return visit_StringNode(node);
            case NODE_STRINGELEMENT:
                return visit_StringElementNode(node);
            // ...
        }
        // ...
    }
};
到此结束了……吗?
当然没有,我们曾经的代码存在着巨量的部分需要我们修改。
首先是变量访问的节点,它会把所有的变量都当成整型,这显然是不合理的。现在我们加一个判断,让它根据变量的类型返回对应的值:
代码 5-12 更新后的变量访问
struct Interpreter {
    Value *visit_VarAccessNode(BaseNode *node_) {
        VarAccessNode *node = (VarAccessNode *) node_;
        Value *val = symbolTable[node->name];
        if (val->getType() == VALUE_INTEGER) return new Integer(*(Integer *) val);
        else if (val->getType() == VALUE_ARRAY) return new Array(*(Array *) val);
        else if (val->getType() == VALUE_STRING) return new String(*(String *) val);
        else return new Null();
    }
};
类似地,数组访问也会把所有的东西当成数组,这里同样要加上对字符串的判断:
代码 5-13 更新后的数组访问
struct Interpreter {
private:
    // ...
    Value *visit_ArrayAccessNode(BaseNode *node_) {
        ArrayAccessNode *node = (ArrayAccessNode *) node_;
        Integer *val = (Integer *) visit(node->index);
        Value *arr = (Value *) symbolTable[node->name];
        if (arr->getType() == VALUE_ARRAY) return new Integer((*(Array *) arr)[int(*val)]);
        return new Integer((int) ((*(String *) arr)[int(*val)]));
    }
    // ...
public: // ...
};
紧接着是 yosoro 语句,它曾经只能输出整型,现在我们给予它输出字符串的能力:
代码 5-14 更新后的 yosoro
struct Interpreter {
private:
    // ...
    Value *visit_YosoroNode(BaseNode *node_) {
        YosoroNode *node = (YosoroNode *) node_;
        Value *ret = visit(node->value);
        if (ret->getType() == VALUE_INTEGER) cout << int(*(Integer *) ret) << ' ';
        else if (ret->getType() == VALUE_STRING) {
            String *thing = (String *) ret;
            cout << thing->str;
        }
        else if (ret->getType() == VALUE_ARRAY) {
            cout << "{";
            Array *arr = (Array *) ret;
            for (int i = arr->start; i < arr->end; i++) {
                cout << (*arr)[i];
                if (i != arr->end - 1) cout << ", ";
            }
            cout << "}";
            cout << " (" << arr->start << ".." << arr->end << ")";
        }
        delete ret;
        return new Null();
    }
    // ...
public: // ...
};
顺手把输出数组也给加上了,因为看着好)
再然后是 set 的部分,虽然对一个字符串的第几个字符进行修改走的仍然是 ArrayAccessNode 的接口,但是实际上它访问的是一个字符串~诶那我为什么不把字符串处理成一个装着一堆ASCII的数组呢~:
代码 5-15 更新后的 set
struct Interpreter {
private:
    // ...
    Value *visit_SetNode(BaseNode *node_) {
        SetNode *node = (SetNode *) node_;
        Value *val = visit(node->val);
        if (node->var->getType() == NODE_VARACCESS) {
            VarAccessNode *vacn = (VarAccessNode *) node->var;
            delete symbolTable[vacn->name];
            symbolTable[vacn->name] = val;
        } else if (node->var->getType() == NODE_ARRAYACCESS) {
            ArrayAccessNode *aracn = (ArrayAccessNode *) node->var;
            Value *index = visit(aracn->index);
            Value *arr = (Value *) symbolTable[aracn->name];
            if (arr->getType() == VALUE_ARRAY) (*(Array *) arr)[int(*(Integer *)index)] = int(*(Integer *) val);
            else if (arr->getType() == VALUE_STRING) (*(String *) arr)[int(*(Integer *)index)] = int(*(Integer *) val);
            delete index;
        }
        return new Null();
    }
    // ...
public: // ...
};
是的你没看错,我在这里直接摆烂了,指针满天飞)
最后是 hor 语句,由于某一处照搬了 set 的逻辑,所以要同步进行改动。
代码 5-16 更新后的 hor 语句
struct Interpreter {
private:
    // ...
    Value *visit_HorNode(BaseNode *node_) {
        HorNode *node = (HorNode *) node_;
        Integer *start = (Integer *) visit(node->start);
        Integer *end = (Integer *) visit(node->end);
        int startval = int(*start);
        int endval = int(*end);
        delete start;
        delete end;
        for (int i = startval; i <= endval; i++) {
            if (node->var->getType() == NODE_VARACCESS) {
                VarAccessNode *vacn = (VarAccessNode *) node->var;
                delete symbolTable[vacn->name];
                symbolTable[vacn->name] = new Integer(i);
            } else {
                ArrayAccessNode *aracn = (ArrayAccessNode *) node->var;
                Value *index = visit(aracn->index);
                Value *arr = (Value *) symbolTable[aracn->name];
                if (arr->getType() == VALUE_ARRAY) (*(Array *) arr)[int(*(Integer *)index)] = i;
                else if (arr->getType() == VALUE_STRING) (*(String *) arr)[int(*(Integer *)index)] = i;
                delete index;
            }
            delete visit(node->body);
        }
        return new Null();
    }
    // ...
public: // ...
};
找不同环节,你能找到不同之处在哪里吗?
至此,我们已经为 CYaRon! 语添加了字符串支持,可以自行编写代码测试。我提供一些简单的直接测试的代码:
{ vars
    a:str
}

:set a, "123456789"
:yosoro a

# 123456789
:yosoro "123\t456\n789"
# 123     456
# 789
{ vars
    a:array[int, 100..105]
}

:set a[100], 1
:set a[101], 2
:set a[102], 3
:set a[103], 4
:set a[104], 5
:yosoro a
# {1, 2, 3, 4, 5} (100..105)
\colorbox{green}{\color{white}\text{练习}}
- 拼图。 将上面的片段拼到前面的完整代码中,拼成一个可以支持四则运算和字符串的 CYaRon! 语解释器。
- 扩展。 添加更多的转义字符,至少先支持全部的
\x吧。 - 改写。 试用 Python 语言仿照文中思路为 CYaRon! 语添加乘除法和字符串支持。
本节完整代码参见:洛谷云剪贴板。
0x06 更多扩展
再往下,CYaRon! 语还应该有更多内容,比如支持函数之类的。但是这个语言太抽象了,添加函数会显得格格不入,所以就摆了。
直到最后,我们的知识储备也不够写未来程序·改的(悲),不过相信看了下一节的参考文献之后各位就有了。
那么,我们手上有了这么一个小玩具了,再往下,该考虑支持些什么呢?由于我个人的知识水平也就到这了,以下权当是指个路:
- 实现函数。这个是最基本的,没有这个很难搞。
- OOP。面向对象,好!但是吧,这后面有一堆坑,请参看参考文献。
- 垃圾回收。我们现在对不会再用到的变量的处理实在是太过粗糙了,这方面单独有一套算法,请参见参考文献自行学习。
- 实现虚拟机。现在 AST 执行还是疑似有些过于慢了,换成虚拟机的话可能会好一些。可以手撕 Token 流,也可以改执行器。总之这一部分算是最好做的。
- 改进报错处理。现在的报错就跟没有一样,所以必须加以改进。
再往后更加先进的东西还有更多,我就不赘述了,《编译原理》的目录可以帮助你)
0x07 参考文献(?)
1.龙书:《编译原理》(第三版)。
2.Crafting Interpreters。目前暂时没有完整的中文译本,可以在线阅读。
3.视频教程:用python制作编译器教程-自制编程语言(bilibili)。自带字幕约等于无,目前还没有烤肉,只能忍着生肉看了。
好了,以上。祝各位在编译原理的世界玩得开心(